Comprendere l’esistente
Ricostruiamo topologia, servizi, carichi e dipendenze.
 ADD SECURITY
SERVER · RETI · STORAGE · VIRTUALIZZAZIONE
L’affidabilità nasce da dipendenze conosciute, fragilità ridotte e un’evoluzione possibile senza ricominciare ogni volta da zero.
Partiamo dai servizi che sostengono il lavoro e ricostruiamo come server, reti, storage, energia e competenze si tengono insieme. Manteniamo ciò che è adeguato, interveniamo sui punti deboli e pianifichiamo il ciclo di vita.
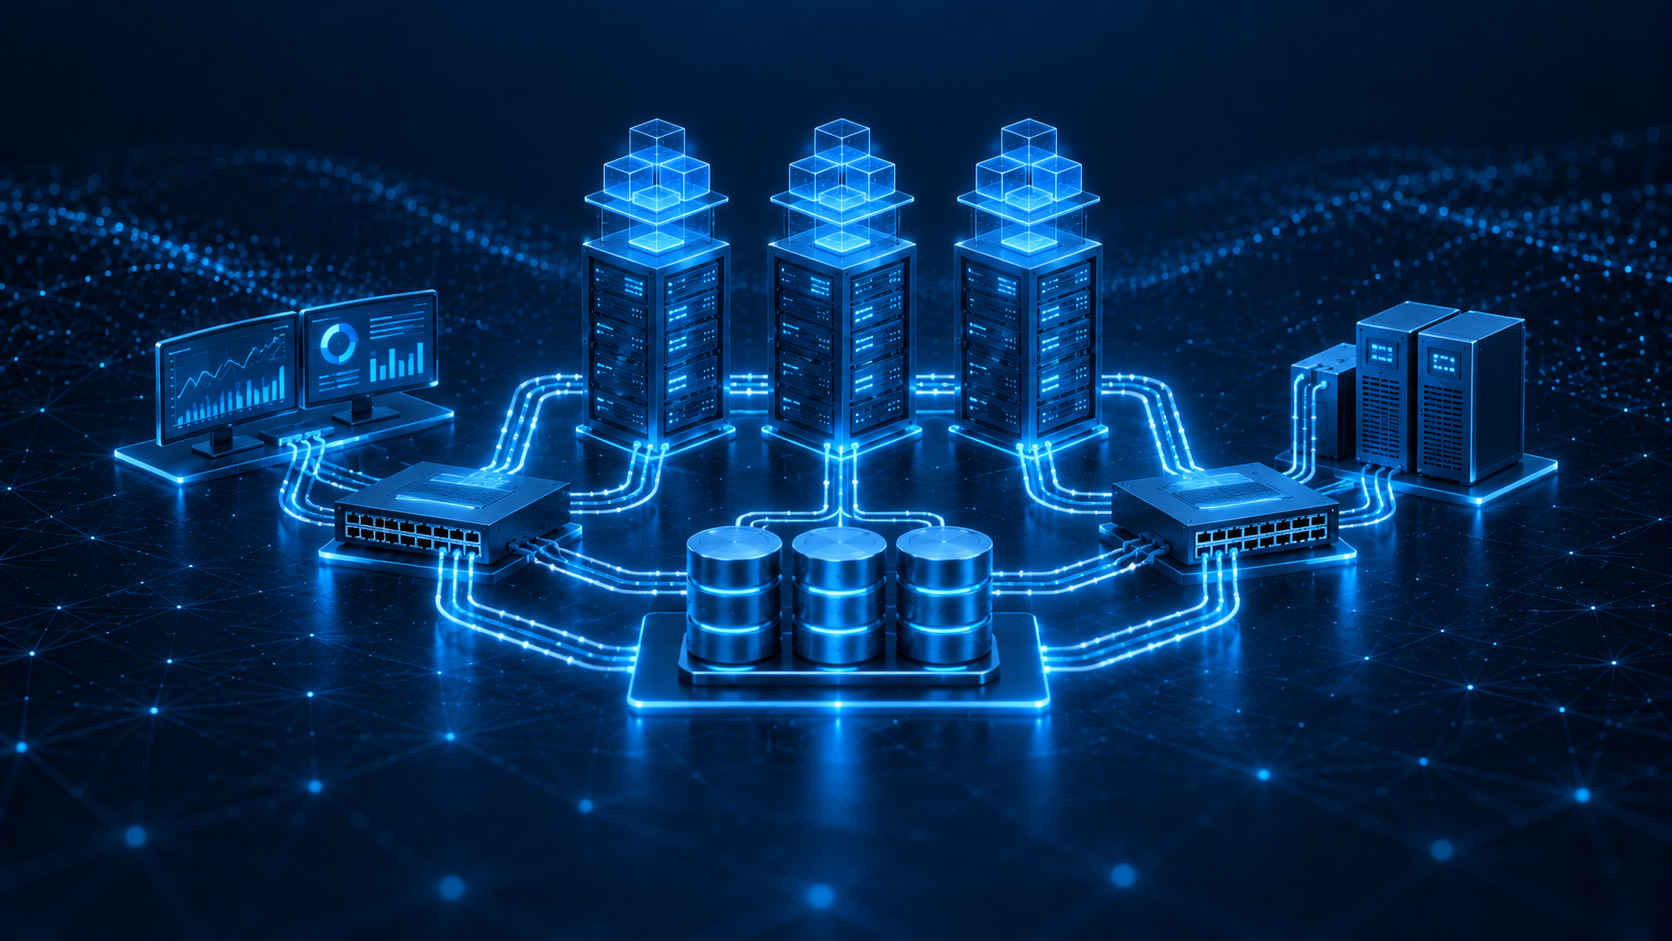
Architettura comprensibile
Dipendenze governate
Evoluzione sostenibile
ARCHITETTURA E DIPENDENZE
QUANDO HA SENSO VERIFICARE
La documentazione non descrive più la topologia, le configurazioni e le dipendenze presenti nei sistemi reali.
Un servizio essenziale dipende da un solo server, switch, storage, collegamento o soggetto che ne conosce il funzionamento.
L’infrastruttura è cresciuta per aggiunte successive, ma capacità, prestazioni e margini residui non vengono misurati.
Virtualizzazione o alta disponibilità sono presenti, ma le procedure di failover, riavvio e ripristino non sono state verificate.
IL NOSTRO METODO
Non partiamo da un server da sostituire. Mettiamo in relazione servizi, componenti, configurazioni e persone per capire dove intervenire e con quale priorità.
Ricostruiamo topologia, servizi, carichi e dipendenze.
Valutiamo impatto, obsolescenza, capacità e punti singoli.
Consolidiamo, separiamo e ridondiamo solo dove serve.
Controlliamo prestazioni, allarmi, procedure ed evidenze.
QUATTRO AREE, UN SOLO SISTEMA
La qualità dell’infrastruttura non coincide con quella del singolo apparato. È il modo in cui le parti lavorano insieme a determinare continuità, manutenibilità e capacità di evolvere.
Risorse dimensionate sui carichi reali, distribuite in modo comprensibile e pronte a evolvere.
Percorsi, segmentazione e ridondanze coerenti con i servizi che devono sostenere.
Prestazioni, capacità e resilienza valutate insieme alle applicazioni e ai tempi di ripristino.
Continuità elettrica, condizioni operative e dipendenze fisiche incluse nel progetto.
Indicatori e soglie utili per riconoscere degrado, saturazione e anomalie prima del fermo.
Configurazioni, modifiche, garanzie e sostituzioni pianificate senza dipendere dalla memoria informale.
RIDONDANZA · ALTA DISPONIBILITÀ · RIPRISTINO
Un cluster continua a dipendere da rete, storage, quorum, alimentazione, configurazioni e gestione. L’alta disponibilità può limitare alcune interruzioni, ma deve essere progettata e verificata nel contesto dell’intero sistema.
Alta disponibilità, backup, monitoraggio, manutenzione e disaster recovery rispondono a problemi diversi. Nessuno di questi elementi sostituisce gli altri.
AFFIDABILITÀ OSSERVABILE
L’affidabilità non è una dichiarazione astratta. Deve lasciare riscontri utilizzabili nel tempo:
PARTIAMO DALL’INFRASTRUTTURA ESISTENTE
Possiamo iniziare dalla topologia, dai servizi essenziali e dalle criticità già percepite, distinguendo ciò che può essere mantenuto da ciò che richiede un intervento pianificato.
Parliamone